原创智谱GLM-5.3-FlashX正式上线,智能、价格、速度三线突破
近日,智谱正式推出全新高速模型GLM-5.3-FlashX,最高生成速度达到每秒200个token,大幅刷新了自身推理速度纪录。对于企业开发者而言,这意味着大模型在实际生产环境中“响应慢、等待久”的痛点得到了实质性缓解,人机交互的流畅度迈上新台阶。
智谱GLM-5.3-FlashX正式上线,智能、价格、速度三线突破
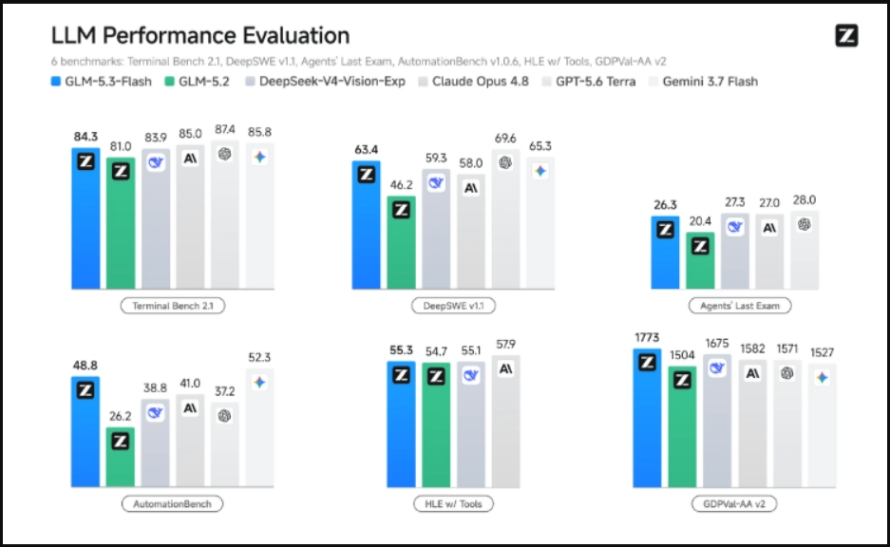
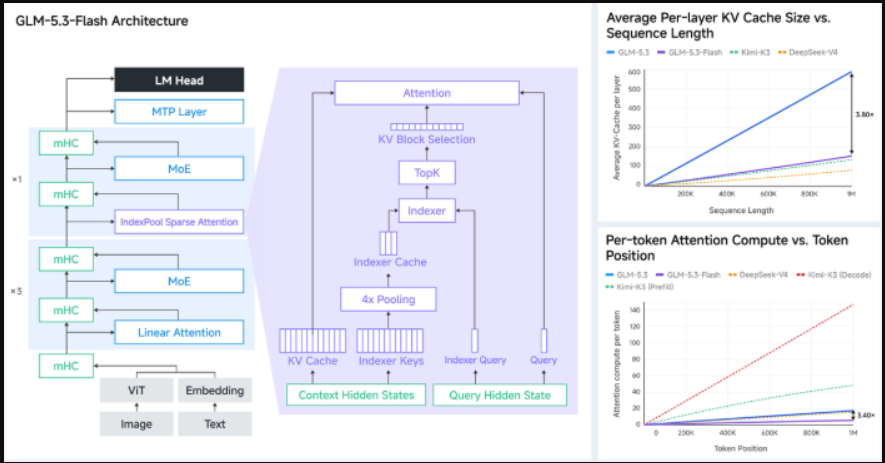
追溯其技术根源,GLM-5.3-FlashX并非凭空而来,它脱胎于此前以代号"Ox Alpha"亮相海外的GLM-5.3-Flash。该模型曾凭借同尺寸参数中的领先智能水平,在海外开发者社区积累了不错的口碑,API调用量持续攀升,市场需求增长势头迅猛。
面对快速膨胀的调用需求,智谱选择持续加码基础设施建设。在已有10万张国产芯片构成推理算力底座的基础上,团队进一步在推理优化与Infra层面投入研发资源,让FlashX得以在智能水平、调用价格与响应速度三个维度上同时占优。
目前,GLM-5.3-FlashX的API已全面上线,接入门槛极低,开发者只需在调用时指定Model Key为"GLM-5.3-FlashX"即可接入。对实时对话、代码补全、智能体高频交互等对延迟敏感的场景来说,它显然是一个不容错过的新选择。