原创DeepSeek发布 V4.1 Flash 大模型 原生支持多模态视觉理解
DeepSeek 官方今日正式发布 V4.1 Flash 大模型。作为 DeepSeek 全新模型结构系列中参数规模最小的版本,该模型具备原生多模态视觉理解能力,主打更高能力上限、更快推理速度与更大吞吐能力,同时支持向更大参数模型平滑扩展。
一、核心架构与性能表现
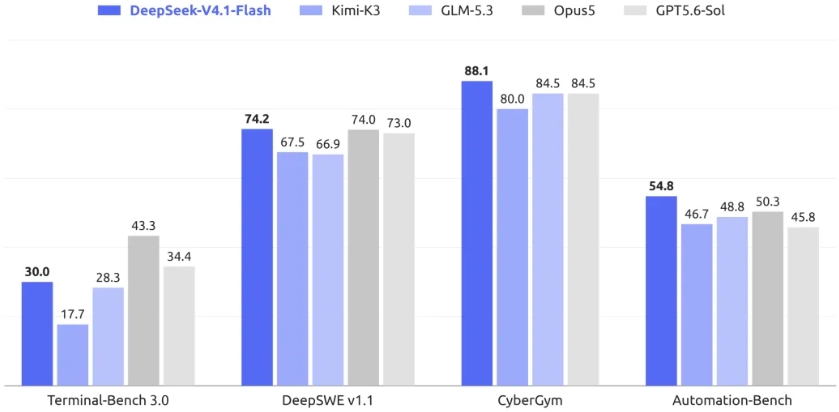
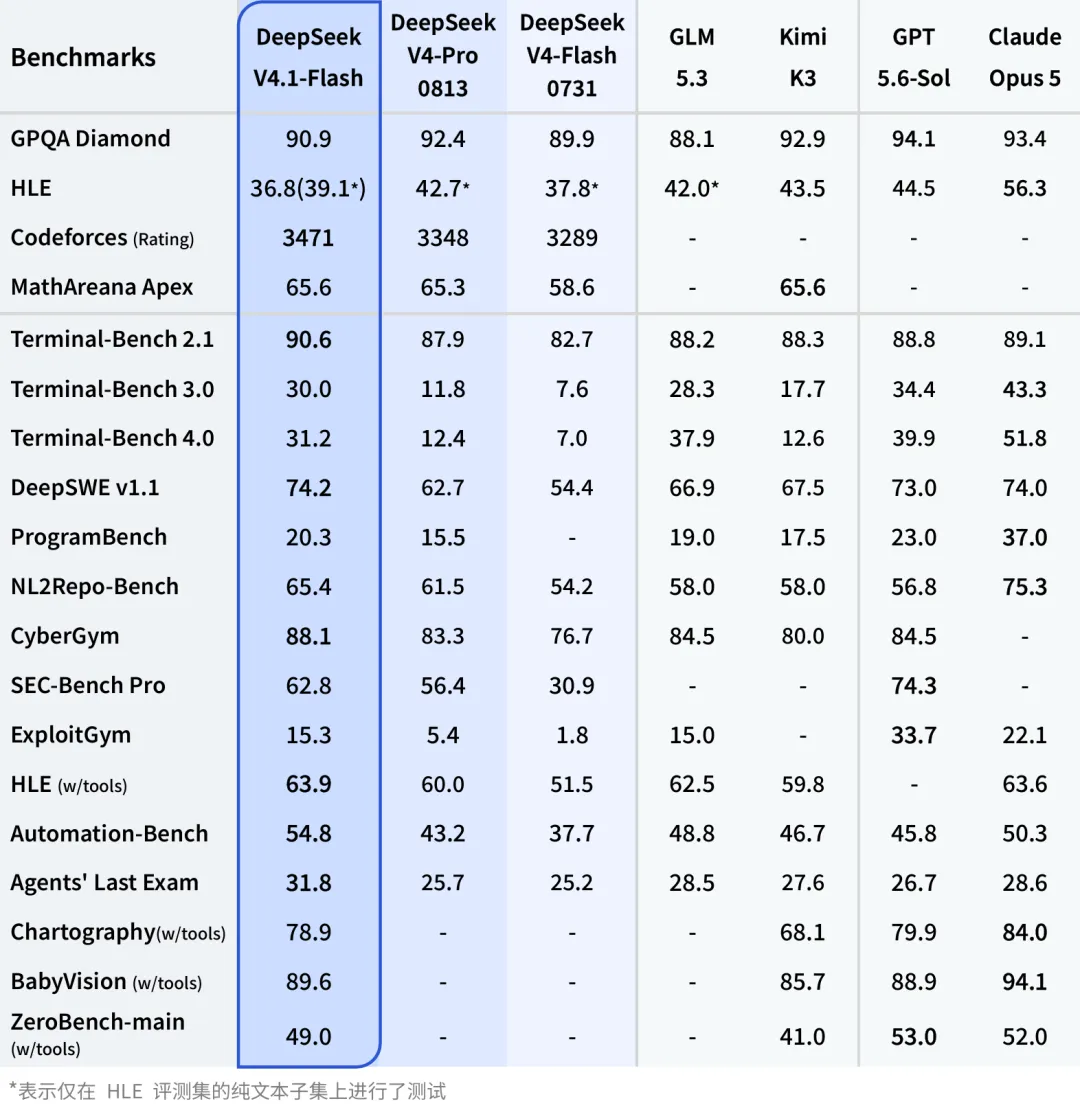
DeepSeek V4.1 Flash 是一款 552B 参数的 MoE 混合专家模型,搭载全新 Causal-Encoder-Decoder 非对称架构,输入与输出侧激活参数不对等,输入端仅激活 8B 参数,输出端激活 16B 参数,运行成本相较同规格模型具备显著优势。经过全新预训练流程与更大规模强化学习后训练,模型综合能力已超越 DeepSeek V4 Pro 等多款旗舰大模型。
二、缓存优化大幅压缩调用成本
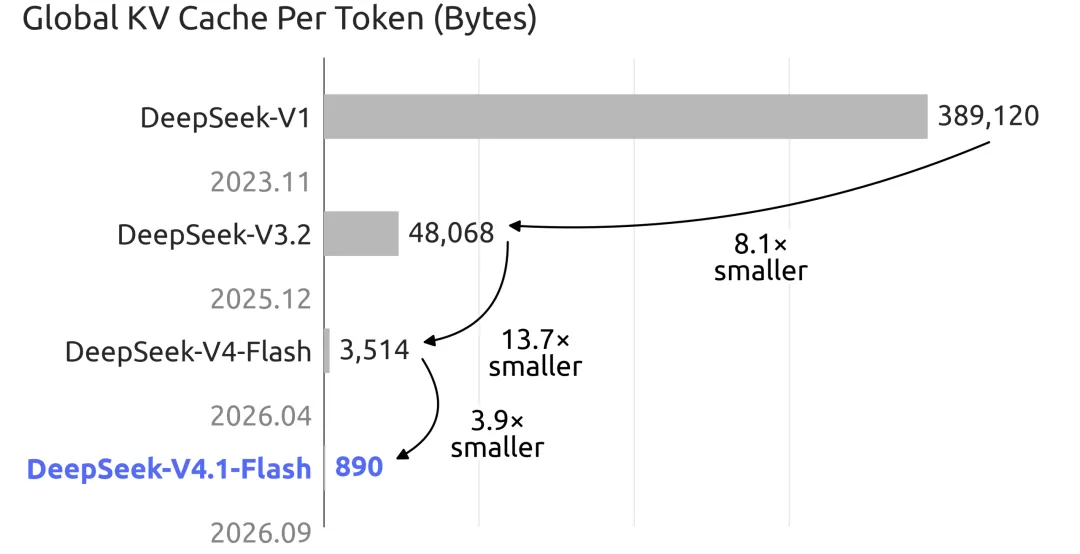
在缓存开销层面,V4.1 Flash 针对 KV Cache 占用进行了深度优化。与上一代产品相比,其 HBM 显存需求降至原先的 1/4.存储需求缩减至 1/8.在 Agent 智能体这类缓存开销占比较高的业务场景中,KV Cache 的压缩优化可显著降低相关任务的调用成本。
三、上线安排与生态适配
目前 DeepSeek V4.1 Flash 已同步上线 DeepSeek API 平台,开发者通过模型标识deepseek-flash即可访问新版本。旧版 V4 Flash 与 V4 Flash Vision Exp 已正式下线,原有模型接口标识将临时路由至 V4.1 Flash,保障业务平滑过渡。 官方同时宣布将逐步下线 V4 Pro 模型:自北京时间 9 月 14 日 12 点起,至 V4.1 Pro 正式发布前,所有指向deepseek-v4-pro的请求将自动切换至 V4.1 Flash,并按新版本标准计费。 生态合作方面,腾讯 WorkBuddy、CodeBuddy 及 OpenCode 作为首批合作方,已完成该模型的全量接入。
四、API 定价同步下调
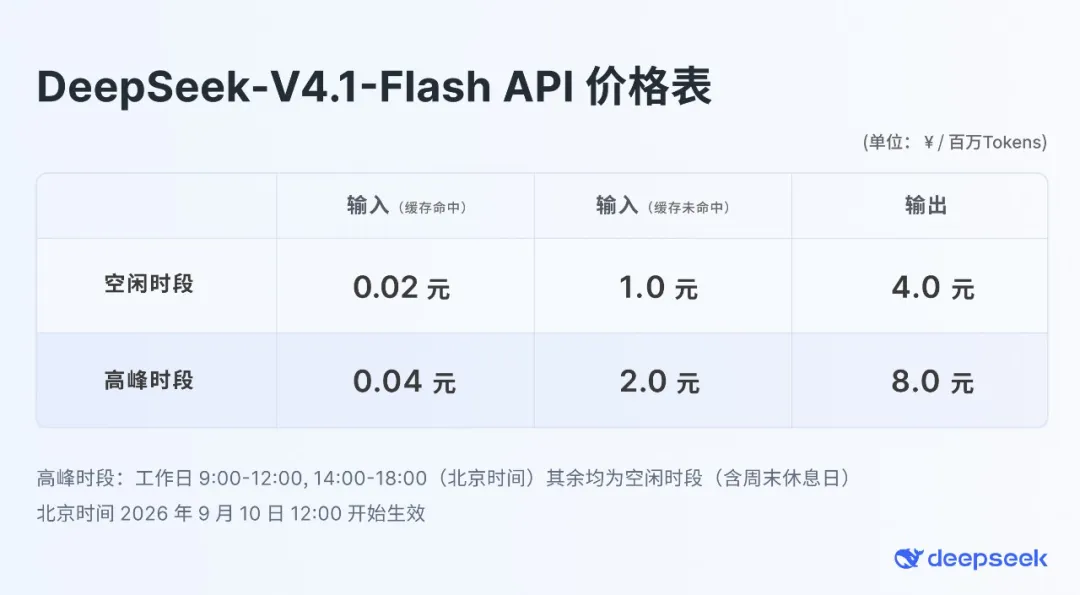
依托架构优化带来的运行成本下降,DeepSeek 同步下调了对应 API 的服务定价。平台继续沿用峰谷分时计费机制,闲时段价格为高峰时段的一半,引导用户错峰使用,新计价规则已于 2026 年 9 月 10 日 12 点正式生效。